【News】Meta、最小・高効率モデル「Muse Ember」を発表 100万トークン対応、入力は100万トークン0.10ドル〜
✎NOTE引用元
- AI at Meta 公式X投稿(一次情報)
https://x.com/AIatMeta/status/2119853591703998787 - Meta開発者ブログ「Start building with Muse Ember」(一次情報)
https://developer.meta.com/ai/resources/blog/build-with-muse-ember - Artificial Analysis:第三者評価の記事
https://artificialanalysis.ai/articles/meta-s-muse-ember-is-the-cheapest-model-scoring-36-on-the-intelligence-index - 解説:Fello AI(価格の段階の指摘)
https://felloai.com/muse-ember/
概要
Metaは、自社のMuseシリーズの中で最小かつ最も効率的とするモデル「Muse Ember」を発表しました。100万トークン(日本語でおおよそ数十万字規模の文章量)の文脈に対応し、エージェント(自分で手順を進めるAI)作業向けの低価格モデルとして打ち出されています。
詳細レポート
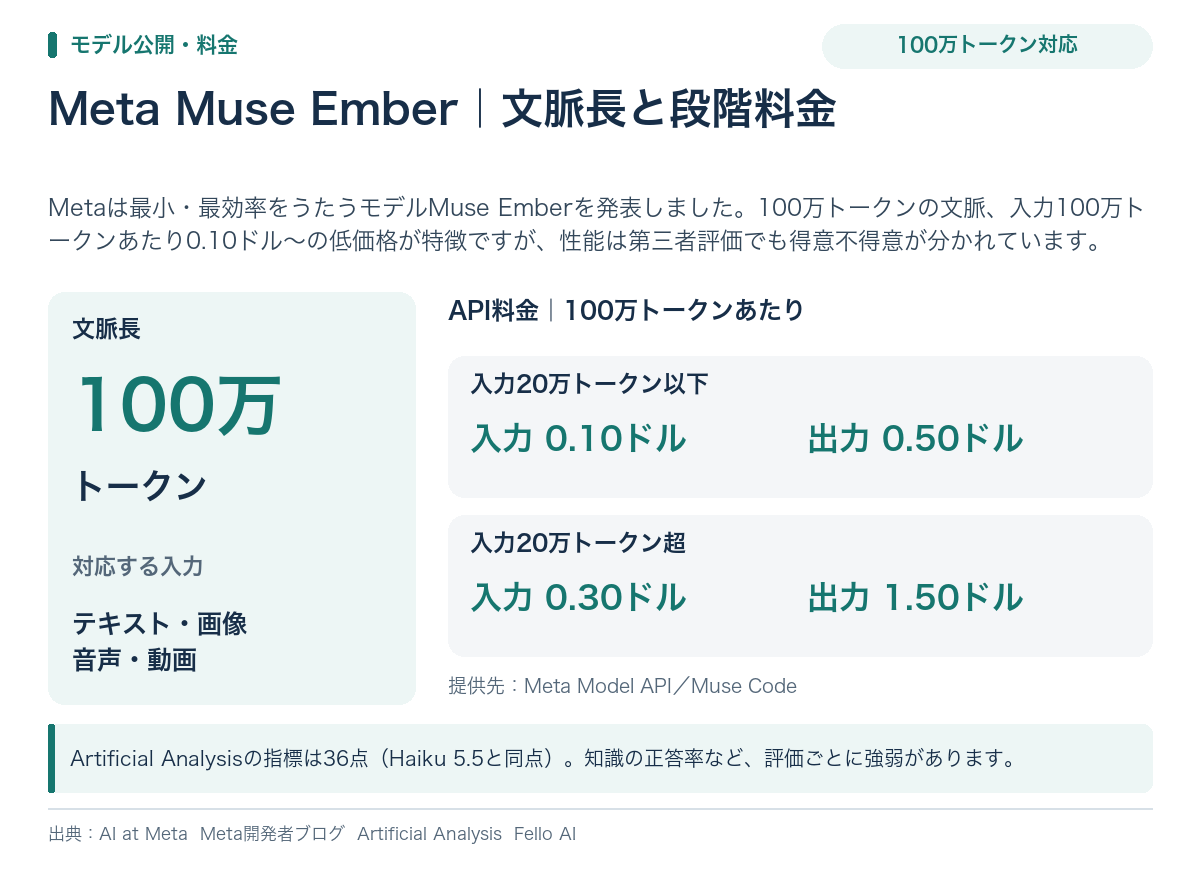
Metaの公式アカウントは、Muse Emberを「最小で最も効率的なモデル」と紹介し、複雑な推論の実行や日常的なエージェント作業向けだと説明しています。投稿には、100万トークンの文脈とあり、アプリをまたぐ作業の遂行、ツールの順次呼び出し、テストの実行、的を絞ったコード修正ができるとしています。Metaの開発者ブログによると、提供はMeta Model APIとコーディングエージェント「Muse Code」で、価格は入力100万トークンあたり0.10ドル〜(20万トークン以下の場合)、出力0.50ドルです。第三者のArtificial Analysisは、総合指標で36点とし、同点の競合より低コストと評価しています。一方で、知識の正確さには弱みがあるとも報告しています。
今回の要点
- Metaは、Muse Emberを最小・最効率のモデルと説明し、100万トークンの文脈とテキスト・画像・音声・動画の入力に対応するとしています。
- 価格は入力100万トークンあたり0.10ドル、出力0.50ドル(入力20万トークン以下)。20万トークンを超えると入力0.30ドル、出力1.50ドルに上がります。
- Artificial Analysisの指標は36点でClaude Haiku 5.5と同点ですが、知識の正答率は低く、ベンチマークごとに強弱が分かれています。
Metaが説明するMuse Emberの位置づけ
Metaの公式X投稿は、Muse Emberを「最小で最も効率的なモデル」としています。想定する用途は、複雑な推論を実行する作業と、日常のエージェント作業です。具体的には、アプリをまたいで作業を進める、ツールを順番に呼び出す、テストを走らせる、コードの一部を直す、といった作業を挙げています。
開発者ブログは、Muse Wonderや Muse Sparkといった上位モデルで計画や難しい推論を行い、Emberは範囲が決まった繰り返し作業に使う組み合わせを勧めています。入力としてテキスト・画像・音声・動画を扱えるとも説明しています。モデルの重み(学習済みのデータ本体)を公開するかどうかは、一次情報では確認できていません。
提供形態と価格
開発者ブログによると、Muse Emberは Meta Model API(モデルID「muse-ember-1.0」)と、Muse Codeの全プランで使えます。OpenAI互換のSDK(開発用の部品)を使っている場合は、接続先のURLを変えるだけで呼び出せると説明されています。
価格は、入力20万トークン以下で入力100万トークンあたり0.10ドル、出力0.50ドルです。20万トークンを超えると入力0.30ドル、出力1.50ドルになります。この段階の存在は、Fello AIが、Meta側の価格表にあると指摘しています。100万トークンの文脈を丸ごと使う場合は、高い方の料金になる点に注意が必要です。
提供形態と価格(Metaの開発者ブログより)
| 項目 | 内容 | 情報の主体 |
|---|---|---|
| 提供先 | Meta Model API/Muse Code | Meta |
| 入力価格(20万トークン以下) | 0.10ドル/100万トークン | Meta |
| 出力価格(20万トークン以下) | 0.50ドル/100万トークン | Meta |
| 20万トークン超 | 入力0.30ドル・出力1.50ドル | Meta(Fello AIが指摘) |
| 対応する入力 | テキスト・画像・音声・動画 | Meta |
性能:Metaの数字と第三者評価
Artificial Analysis(AIモデルの性能と価格を比較する第三者機関)は、Muse Emberを総合指標「Intelligence Index」で36点と評価しています。Claude Haiku 5.5の最大設定と同点で、1タスクあたりの費用は0.14ドルと、Haiku 5.5の0.41ドルの約3分の1だと報告しています。コーディングエージェント向けの指標でも、Muse Code上のEmberは46点で、Claude CodeのHaiku 5.5の37点を上回っています。
一方で、同機関は弱みも報告しています。知識の正答率は21.1%で、比較対象より低く、約64%の質問には答えない設定です。個別の試験では、Terminal-Bench 4.0は40.9%でHaiku 5.5の32.8%を上回りましたが、FrontierCode 2.0は27.2%で、Haiku 5.5の34.9%を下回っています。Metaが開発者ブログで示した別の数字には、Meta内部の複合指標も含まれ、これは第三者による検証ではありません。
主な性能指標(Artificial Analysisの報告)
| 指標 | Muse Ember | Claude Haiku 5.5 | 主体 |
|---|---|---|---|
| Intelligence Index(最大設定) | 36 | 36 | Artificial Analysis |
| 1タスクあたり費用 | 0.14ドル | 0.41ドル | Artificial Analysis |
| Terminal-Bench 4.0 | 40.9% | 32.8% | Artificial Analysis |
| FrontierCode 2.0 | 27.2% | 34.9% | Artificial Analysis |
| 知識の正答率 | 21.1% | 34.7% | Artificial Analysis |
読み解くポイントと未確認の点
低価格で長い文脈を扱える点は、大量の文書を繰り返し処理する業務には魅力になり得ます。ただし、知識を問う用途では正答率が低めで、答えを控える設定の影響も大きいと同機関は指摘しています。社内の事実確認のような用途では、上位モデルとの使い分けが前提になりそうです。
確認されていない点もあります。まず、モデルの大きさ(パラメータ数)や応答速度は、Artificial Analysisの記事に記載がありません。また、日本語での性能やMeta製品への組み込み計画は、確認した一次情報には載っていません。導入を検討する場合は、自社の作業で試して確かめるのが確実です。